RAG vs Fine-tuning : quelle approche pour vos projets IA ?
Dès qu’un projet d’intelligence artificielle sort du simple chatbot générique, la même question revient : faut-il faire du RAG (Retrieval-Augmented Generation) ou fine-tuner un modèle ? Les deux approches permettent d’adapter un grand modèle de langage (LLM) à un contexte métier, mais elles répondent à des besoins différents, ont des coûts différents et n’offrent pas les mêmes garanties. Voici un comparatif concret pour choisir la bonne stratégie.
Sommaire
- RAG et fine-tuning : deux logiques différentes
- Comment fonctionne le RAG
- Comment fonctionne le fine-tuning
- Comparatif : coût, fraîcheur des données, complexité
- Quand privilégier le RAG
- Quand privilégier le fine-tuning
- L’approche hybride
RAG et fine-tuning : deux logiques différentes
Le RAG consiste à laisser le modèle tel quel et à lui fournir, au moment de la requête, les informations pertinentes récupérées dans une base de connaissances externe (documents, base vectorielle, API interne). Le fine-tuning, à l’inverse, consiste à ré-entraîner (ou entraîner partiellement) le modèle sur un jeu de données spécifique pour modifier son comportement ou ses connaissances de façon durable.
Dans le premier cas, on change ce que le modèle voit avant de répondre. Dans le second, on change ce que le modèle sait intrinsèquement.
Comment fonctionne le RAG
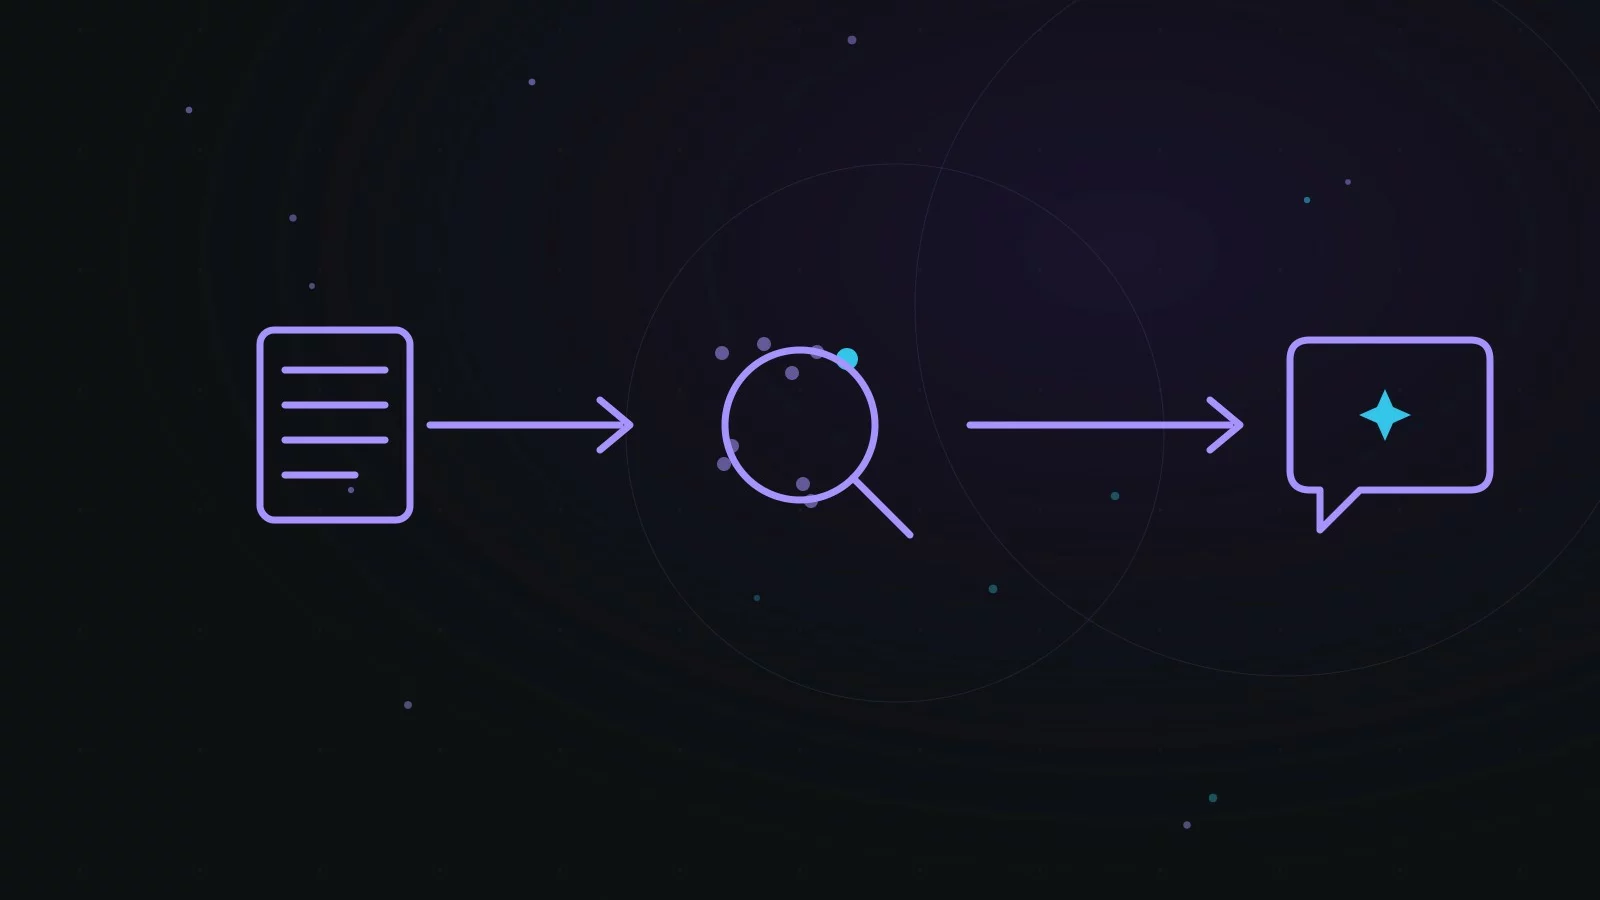
Un pipeline RAG classique repose sur trois étapes : l’indexation des documents sous forme de vecteurs (embeddings) dans une base vectorielle, la recherche des passages les plus pertinents par rapport à la question posée, puis l’injection de ces passages dans le prompt envoyé au LLM. Le modèle génère ensuite sa réponse en s’appuyant sur ce contexte fourni, plutôt que sur sa seule mémoire d’entraînement.
Cette approche permet de connecter un LLM à des données propriétaires, à jour, sans jamais toucher aux poids du modèle.
Comment fonctionne le fine-tuning
Le fine-tuning part d’un modèle pré-entraîné et poursuit son entraînement sur un jeu de données plus restreint et spécialisé. Il existe plusieurs variantes : le fine-tuning complet (coûteux, rarement nécessaire), et des techniques plus légères comme LoRA ou QLoRA qui n’ajustent qu’un sous-ensemble de paramètres, réduisant fortement le coût de calcul.
Le résultat est un modèle qui a « intégré » de nouveaux comportements, un ton, un format de sortie ou des connaissances spécifiques — sans avoir besoin de les lui rappeler à chaque requête.
Comparatif : coût, fraîcheur des données, complexité
Sur le coût de mise en œuvre initial, le RAG est généralement plus rapide et moins coûteux à mettre en place : pas d’entraînement, une base vectorielle et un pipeline de récupération suffisent. Le fine-tuning demande des données d’entraînement de qualité, du calcul (GPU) et une phase d’évaluation plus longue.
Sur la fraîcheur des données, le RAG gagne largement : mettre à jour un document dans la base vectorielle suffit à changer la réponse du modèle, sans ré-entraînement. Un modèle fine-tuné, lui, reste figé sur les données au moment de l’entraînement.
Sur la latence et le coût par requête, le RAG ajoute une étape de recherche et allonge le prompt (donc le coût en tokens), alors qu’un modèle fine-tuné répond directement, avec un prompt plus court.
Sur la traçabilité, le RAG permet de citer ses sources (quels documents ont été utilisés pour répondre), ce qui est précieux pour la confiance et l’audit. Le fine-tuning, lui, est une boîte plus noire : il est difficile de savoir précisément quelle donnée d’entraînement a influencé une réponse donnée.
Quand privilégier le RAG
Le RAG est le choix naturel quand les données évoluent souvent (documentation produit, base de connaissances interne, catalogue), quand la traçabilité des réponses est importante, ou quand le volume de données à exposer est trop grand pour être « appris » efficacement par fine-tuning. C’est aussi l’option la plus simple pour démarrer un projet et itérer rapidement.
Quand privilégier le fine-tuning
Le fine-tuning devient pertinent quand il s’agit de modifier un comportement stable et récurrent du modèle : un format de sortie très spécifique, un ton ou un style de rédaction constant, une terminologie métier à intégrer profondément, ou des tâches structurées répétitives (classification, extraction) où la cohérence prime sur la fraîcheur des données.
L’approche hybride
Dans la pratique, les deux approches ne s’excluent pas. Il est courant de fine-tuner un modèle pour qu’il adopte un format de réponse ou un comportement précis, tout en le connectant à un pipeline RAG pour lui donner accès à des informations à jour. Le choix n’est donc pas binaire : il dépend des contraintes réelles du projet — fraîcheur des données, budget, exigences de traçabilité et complexité acceptable.
Chez Any In IT, nous concevons des architectures RAG et des pipelines d’intégration LLM adaptés aux données et aux contraintes réelles de chaque projet, plutôt que d’appliquer une solution toute faite.
À lire aussi
Concevoir une architecture microservices avec Laravel et Docker
Découper une application Laravel monolithique en microservices n'est pas toujours la bonne réponse. Principes, apports de Docker et pièges à éviter.
PHP 8.3 : les nouveautés qui comptent pour les développeurs Laravel
PHP 8.3 apporte plusieurs évolutions utiles au quotidien pour un développeur Laravel : constantes typées, readonly amélioré, nouvelles fonctions. Ce qu'il faut retenir.
Redis : cache, sessions et files d’attente dans Laravel
Redis est l'un des outils les plus utilisés pour accélérer une application Laravel : cache, sessions, files d'attente. Tour d'horizon de ses usages concrets.